效率方法 · 中文译文
Claude Code 使用技巧大全:如何让 Claude 写代码更准、更快、更省 Token
Maximizing the value of your Claude Code sessions
本文译自 Claude by Anthropic 官方博客,版权归原作者及 Anthropic 所有。若译文与原文存在差异,请以英文原文为准。文中产品与功能以原文所述产品为准。
输入与输出 Token
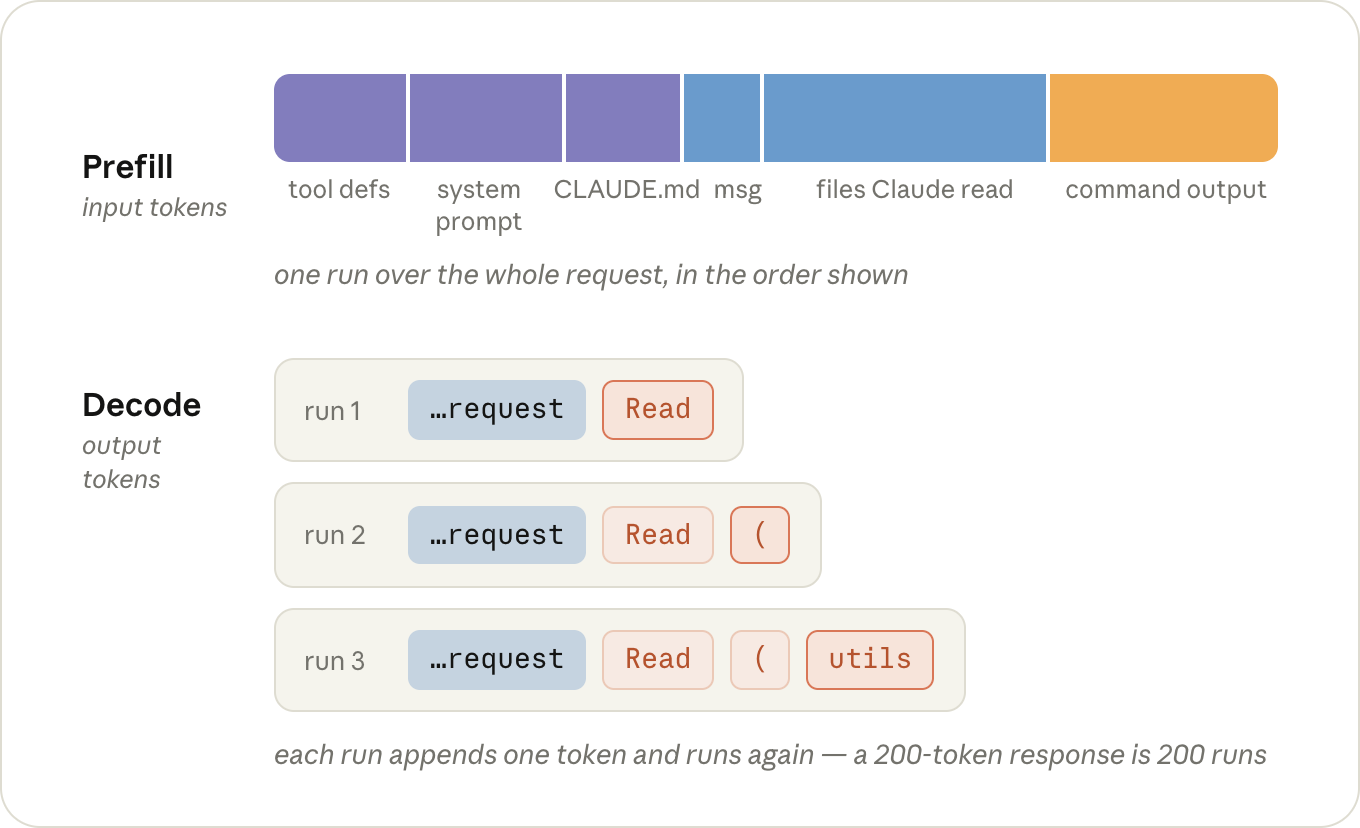
一个请求会分两个阶段通过 GPU,这两个阶段的成本不同。
首先,在预填充(prefill)阶段,模型会读取你的请求和 Context:系统 Prompt、你的 CLAUDE.md、你的消息,以及此后添加到对话中的所有内容(Claude 读取过的文件和所运行命令的输出)。这些就是输入 Token。
接着,在解码(decode)阶段,它会写出输出 Token:它的思考、发起的工具调用,以及你看到的文本。这个过程一次生成一个 Token;一条包含 200 个 Token 的回复,意味着模型连续运行 200 次。按每个 Token 计算,解码占用 GPU 的时间要长得多,因此输出的定价约为输入的 5 倍。
一次会话中的许多输出 Token 都是思考 Token,而模型每轮进行多少思考,正是由 Effort 级别控制的。和模型选择一样,你通过 /effort 选定的级别也会保留,并成为下一次会话的默认设置。
**技巧:**在新会话中运行一次
/model和/effort,确认自己实际使用的配置。两者都会记住你上次的选择,因此最好有意识地作出这个决定。
**技巧:**如果你已经知道某次会话只是处理机械性的工作,使用
MAX_THINKING_TOKENS=0claude 可以为这一次会话关闭思考(Fable 5 除外),其级别比/effortlow 还低一档。
Prompt 缓存
如果一个请求开头的 Token 与服务器刚刚处理过的请求完全相同,那么这段共同开头所产生的状态也相同,因此服务器可以保留上一次的状态,只对后续新增的部分进行预填充。这称为 Prompt 缓存。
从缓存读取的成本为输入价格的 0.1 倍,因为服务器只需加载状态,而不必重新计算。将 Token 写入缓存的成本略高于普通输入,最高为 2 倍,因为服务器之后还必须保留相应状态。但每个 Token 只需写入一次,而后续每一轮都能以 0.1 倍的价格读取。
Claude Code 会在每次请求时管理 Prompt 缓存,无需手动开启。但你可能会破坏缓存,因此了解如何避免由此造成的成本激增非常重要。
假设我们输入“修复 utils.test.ts 中失败的测试”。Claude Code 会按以下方式发送请求:
Claude Code 用系统 Prompt(包括工具定义)、你的
CLAUDE.md和你的消息组装第一个请求,并将其发送出去(输入 Token)。此时缓存还是空的,所以所有内容都会经过预填充并写入缓存。模型无法修复一个自己尚未见过的测试,因此会短暂思考,然后发起一次针对
utils.test.ts的 Read 调用(输出 Token)。Claude Code 读取该文件,将其追加到对话中,再次发送整个对话(输入 Token)。这一次,请求 1 的全部内容都会以十分之一的价格从缓存中读回,只有新增内容会以全价进行预填充:Read 调用和文件内容。现在模型需要查看被测试的文件(输出)。它再次发起 Read、再次追加内容,然后再次发送全部内容:请求 1 和请求 2 从缓存读取,第二个文件按全价处理(输入)。
模型以一次 Edit 调用作出响应(输出)。Claude Code 应用编辑、追加结果,然后再次发送所有内容。情况相同:Edit 及其结果是新增内容,位于它们之前的一切都从缓存读取(输入)。
模型运行
npm test(输出)。Claude Code 追加测试输出并再次发送所有内容,其中只有测试输出是新增部分(输入)。测试通过,模型给出一段简短总结(输出)。由于没有工具调用,也就没有需要追加的内容,更不会出现请求 6,因此到此结束。
一个小修复就产生了五个请求,而每个请求都包含截至当时的完整对话。典型的一轮并不均衡:输入数万个 Token,输出只有几百个。但只有该轮新增的内容才会以全价进行预填充。
这就是每轮的全部费用构成:历史记录的缓存读取费用、新增内容的全额输入费用,以及响应的输出费用。
订阅方案同样如此。你不会直接看到这些价格,但消耗使用限额的正是这些请求。
缓存必须从请求的最开头开始连续匹配,而请求的内容始终以相同顺序发送:先是工具定义,然后是系统 Prompt,最后是对话(CLAUDE.md 位于对话最前面)。
如果这个前缀中的任何内容发生变化,其后的所有内容都必须重新进行预填充。将工具结果追加到对话末尾是最理想的情况,因为后面没有其他内容。真正会使缓存失效的,是任何改变请求中更靠前内容的操作,或者改变缓存键依据的操作:
/model:每个模型都有各自的缓存,因此下一轮会以全价重新预填充整个对话。(这也包括 opusplan,因为每次进入或退出 plan mode 时,它都会切换模型。)/effort:Effort 级别也是缓存键的一部分,因此情况相同。这正是为什么在对话中途切换/model或/effort时,两者都会要求你确认。- Fast mode:它同样是缓存键的一部分,重新预填充会按 fast mode 的价格计费,所以如果准备开启,最好在会话开始时就开启。(从缓存角度看,再次关闭它是免费的。)
/compact:对话会被替换为较短的版本,因此其中的内容不再匹配(位于它之前的系统 Prompt 仍能保留)。只要旧对话仍在缓存中,生成摘要本身的成本很低,因此在长时间离开之前执行,要比离开后再执行便宜得多。- **时间:**每一轮都会重置计时,但订阅方案的缓存会在一小时后过期,使用 API key 时则会在五分钟后过期(
ENABLE_PROMPT_CACHING_1H=1可将其延长至一小时)。如果超过这个时间才回来,下一轮会重新预填充整个对话。恢复旧会话几乎也总是如此:到那时缓存通常已经消失,而且系统 Prompt 在启动时无论如何都会重新构建。
这并不意味着你永远不该切换模型或 Effort,而是说切换有便宜的时机——会话开始时或刚执行 /clear 后;也有昂贵的时机——一段长对话进行到一半时。
**技巧:**如果最近几轮偏离了你想保留的方向,应使用
/rewind回到这些轮次之前,而不是运行/compact。回退只会从末尾截去这些轮次,因此它们之前的内容仍在缓存中,不会产生额外成本。压缩会重写整个对话,所以总会产生一些成本。
决定一次会话会发送多少 Token 的因素
这里最重要的一点是:没有任何内容只发送一次。所有最终进入对话的内容——Claude 读取的文件或它运行命令的输出——都会在之后每一轮中再次发送,直至会话结束。
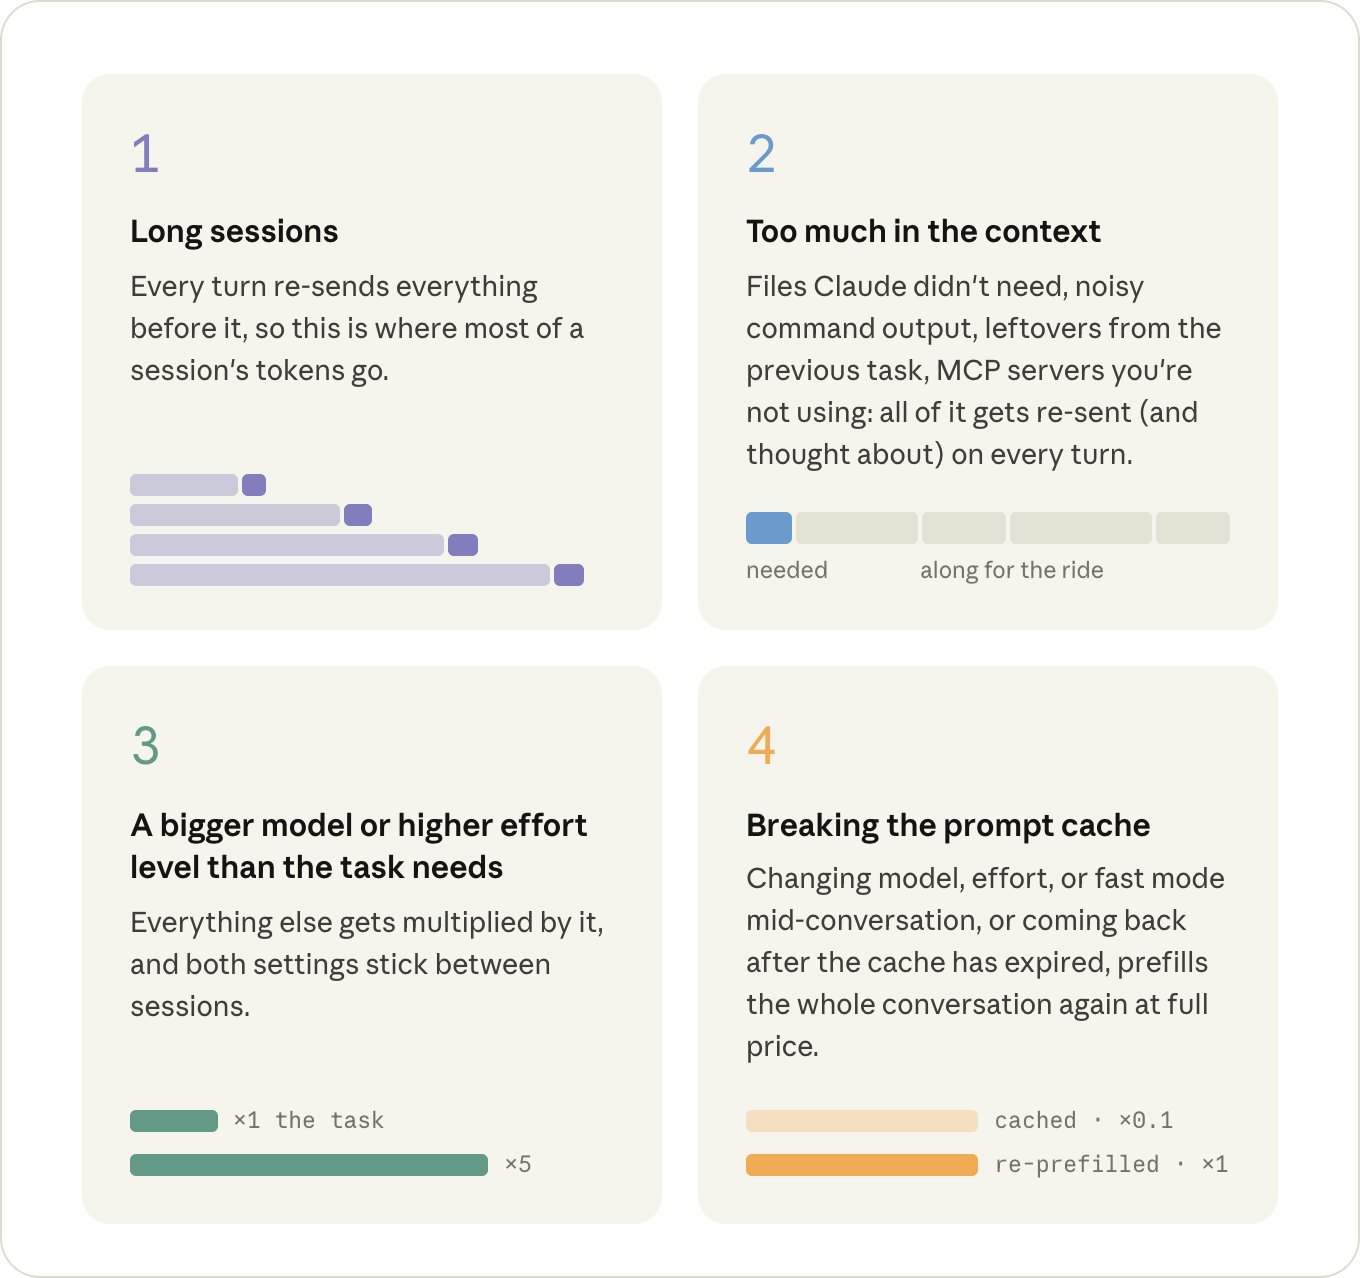
这些内容已经被缓存,所以每次重发的成本很低,但低成本不等于零;而且每一轮中,它们还会占用模型进行思考时需要处理的 Context 空间。
这其实就是会话的完整成本模型:有多少 Token 进入 Context、它们在那里保留多少轮,以及你同时运行多少个 Context。
哪些内容会进入 Context
Context 中有一部分内容在你输入任何文字之前就已存在:工具定义、系统 Prompt、CLAUDE.md,以及启动时加载的其他内容。
技巧:在新会话中运行
/context,查看自己尚未输入任何内容时其中已经有什么。CLAUDE.md中只保留明确具体的指令,将与特定工作流相关的指令移入 Skills,因为 Skills 只会在使用时加载。如果本次会话不需要某个 MCP server,请用/mcp将其关闭。
会话期间新增的内容几乎全是工具结果:Claude 读取的文件,以及它运行命令得到的输出。
Claude 会读取多少内容,主要取决于它必须自行摸索多少信息。如果你只说“测试失败了”,它首先必须查明哪些测试失败:进行一两次 grep、打开几个文件以判断哪个相关,而所有这些结果即使早已失去作用,仍会留在 Context 中。
“修复 utils.test.ts 中失败的测试”省去了搜索,只需一次 Read 调用来读取文件;而“修复 @utils.test.ts 中失败的测试”连这次 Read 调用也省了。
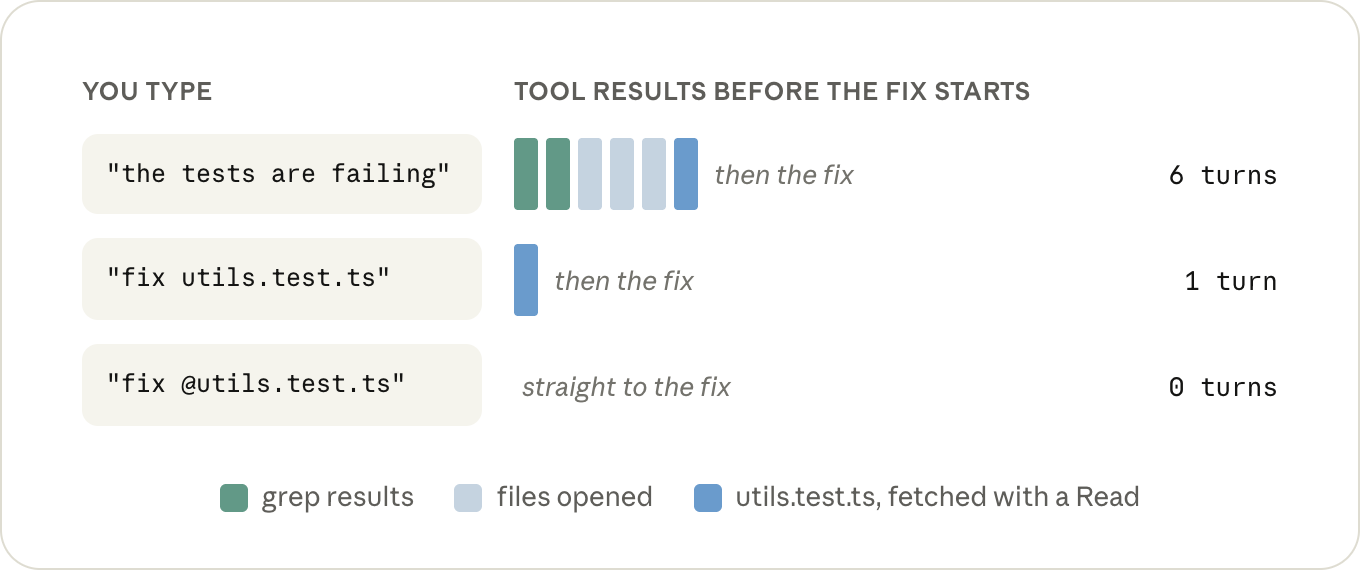
**技巧:**引用文件时,请用 @ 提及文件,而不是直接输入路径。Claude Code 会在发送任何内容之前,将文件附加到你的消息中,因此它会出现在第一个请求里,无需为此发起 Read 调用。无论采用哪种方式,文件本身在 Context 中占用的空间都一样,所以每次对话只需提及一次:它会一直保留在那里,而在后续轮次中再次 @ 提及,通常会附加第二份副本。
另一个会填满 Context 的因素,是 Claude 所运行命令的输出。每当它运行测试、构建或 git log 时,命令打印出的所有内容都会像读取的文件一样追加到对话中,并保留同样多的轮次。
特别大的输出其实没有问题:超过 30,000 个字符后,Claude Code 会把输出写入文件,并且只在对话中放入简短预览和文件路径(如果想调整这一限制,可使用 BASH_MAX_OUTPUT_LENGTH)。
问题出在所有低于这一限制的输出。一个逐行打印 400 项通过测试的测试运行器,其输出并未超过限制,于是这 400 行会成为之后每一轮的一部分。
Claude 往往会使用参数和 tail 帮你处理这类问题;如果你不想让 Claude 自行决定,文档中有一个小型 Hook,可以在嘈杂的命令运行前重写它们,使返回内容仅包含重要的行。
技巧:把你每天都要运行的两三个命令放进
CLAUDE.md,包括用于精简输出的参数,并按照你自己会输入的方式来写(“使用npx vitest run <file> --reporter=dot运行单个测试文件”)。这只是很小的补充,却能在此后的每次会话中省下一轮,并减少几百行输出。
内容会在其中保留多少轮
一次长会话比将同样的工作分散到几个短会话中的成本更高,而且高出的幅度可能超乎你的想象,因为第 40 轮还会重新读取此前的 39 轮。你应当让会话中的 Context 保持简短且相关,因此不要把一个任务的 Context 带到下一个任务中:开始新任务时使用 /clear,同一任务的前半部分完成后则使用 /compact。
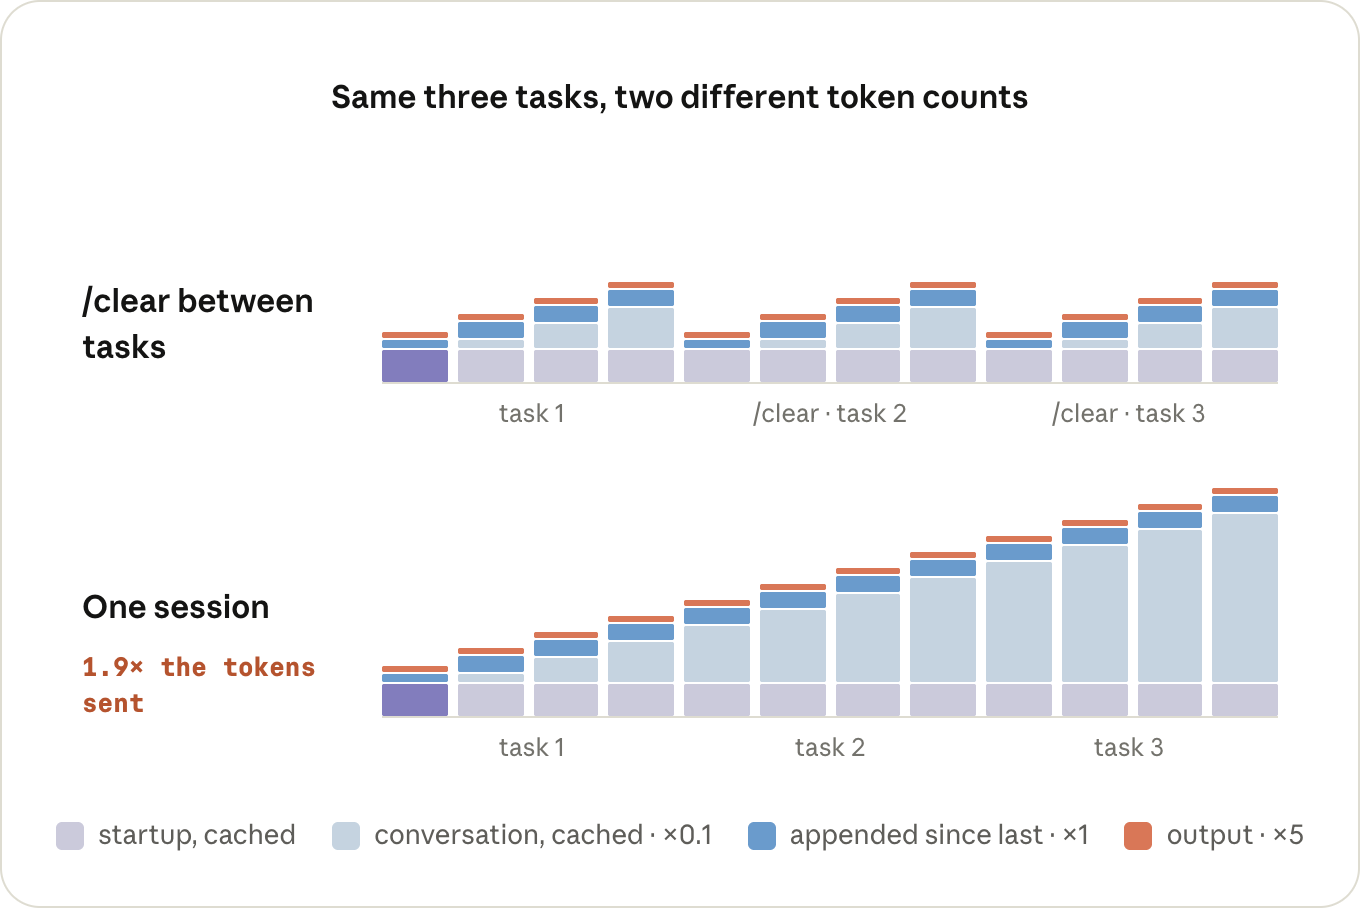
技巧:如果以后还想找回该会话,请先执行
/rename,再执行/clear。使用/compact时,要告诉它应该保留哪些内容;如果每次要求都一样,可以在CLAUDE.md中加入一个“Compact instructions”章节。如果你使用的是 1M 模型,并希望恢复到过去的 auto-compact 安全阈值,执行/autocompact 200k即可恢复(需要 Claude Code v2.1.221+)。
也要留意你没有输入内容时发生的轮次。一次 /loop 每次触发时,都会在你创建它的会话中作为完整的一轮执行,并且每次都携带该会话的全部对话;如果距离上一轮已经超过一小时,还会额外发生缓存未命中。请在另一个终端中新建会话,并从那里运行该 loop。
Subagent
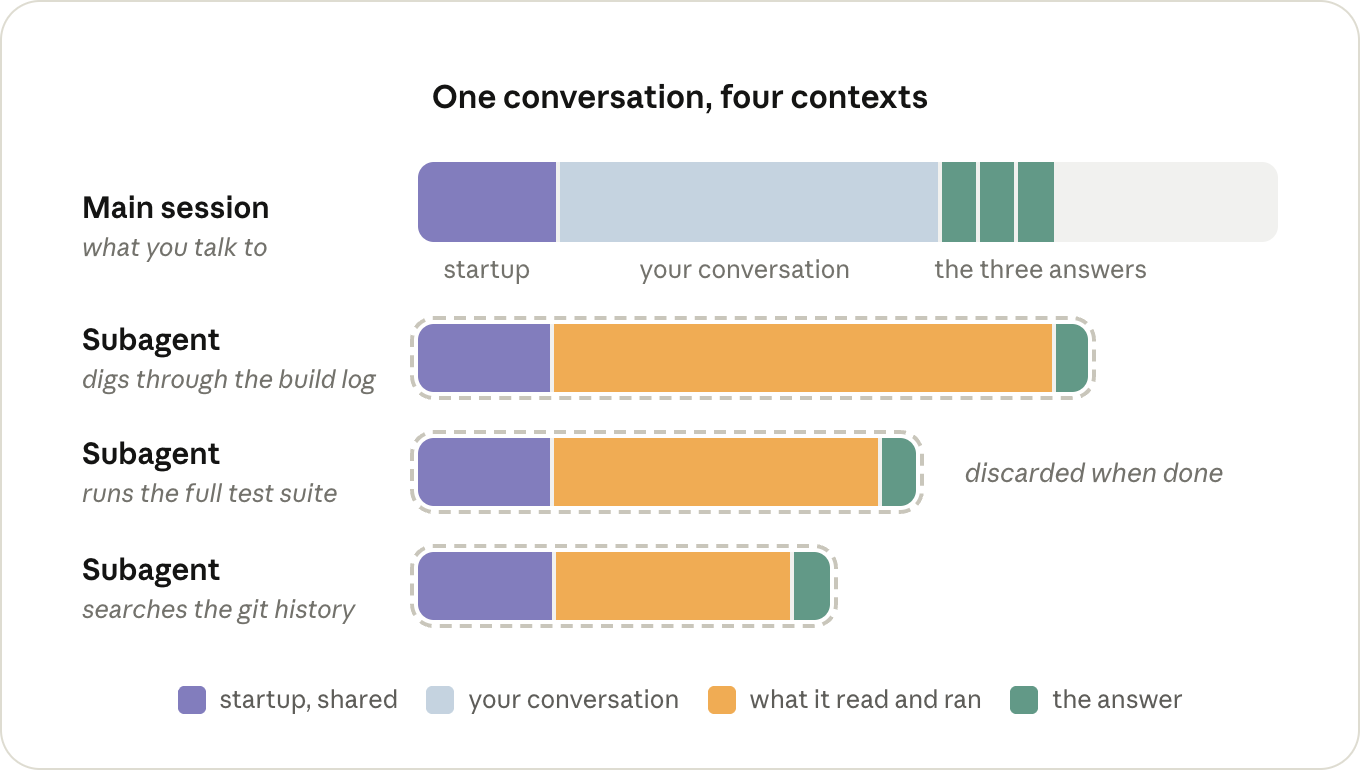
另一种让某些内容不进入你的 Context 的方法,是让相关操作在另一个 Context 中发生,而这正是 Subagent 的用途。Subagent 有自己的 Context window,其中包含自己的系统 Prompt、工具和你的 CLAUDE.md,但不包含你的对话。它会独立运行自己的轮次,最终只有它的回答会返回主会话。任务完成后,其他一切内容都会被丢弃。
无法访问你的对话也有缺点:Subagent 有时必须重新读取主会话已经拥有的内容,并且在此过程中,它也要为自己的轮次付出成本。对于小任务而言,这只会增加额外开销。
当某项任务会产生大量无需保留的输出时,例如分析日志,Subagent 就能带来回报。对于这类工作,Claude 往往会主动使用 Subagent;如果它没有这样做,你也可以直接要求(“在 Subagent 中分析这份日志”)。但请记住,主会话最终只能获得 Subagent 选择汇报的内容。
技巧:如果你反复交办某项会产生大量输出的任务,可以专门为它创建一个 Subagent 定义,并设置 model: haiku(或 sonnet)。否则,它会使用主会话当前运行的模型。
应优先关注哪些方面
在上述所有内容中,有四件事值得留意。按大致成本由高到低排序如下: